数据处理流水线
每个知识库都有一条可视化入库流水线(React Flow 画布):文档从上传到可检索,经过五个节点。打开知识库 →「流水线」标签查看:
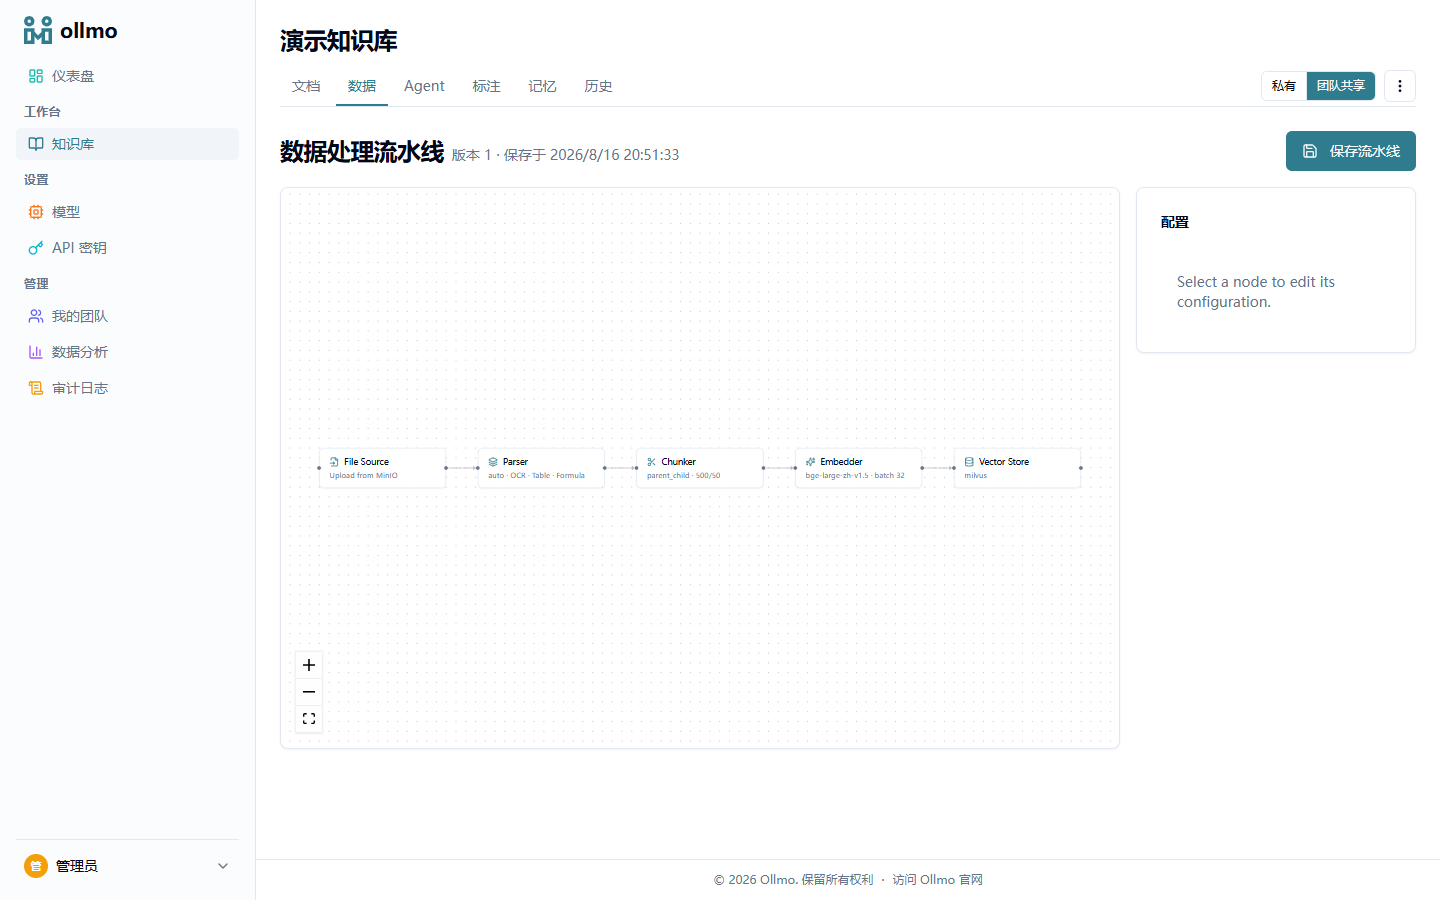
节点说明
| 节点 | 作用 | 关键配置 |
|---|---|---|
| 来源 (Source) | 文档入口 | 文件上传 / URL 导入 |
| 解析器 (Parser) | 抽取文本与结构 | 引擎:auto / MinerU / 本地;OCR、公式、表格开关 |
| 分块器 (Chunker) | 文本切分 | 策略、块大小、重叠长度 |
| 向量化 (Embedder) | 生成向量 | Embedding 模型、批大小 |
| 存储 (Sink) | 写入向量库 | 类型(Milvus) |
分块策略
| 策略 | 标识 | 适用 |
|---|---|---|
| 段落分块 | paragraph | 按自然段落打包切分,保留语义完整性(未知策略的兜底) |
| 固定长度 | token | 按字符数固定切分(可设重叠),结构规整的文档,速度快 |
| 父子分块 | parent_child | 子块检索、父块送入 LLM,兼顾精度与上下文,默认推荐 |
| 标题感知 | header | 按文档标题层级切分,保留章节结构 |
| 问答分块 | qa | CSV 问答对(一行一问一答),命中即返回标准答案 |
父块保留更大的上下文,检索命中子块时携带父块内容进入 LLM,回答更完整。
解析引擎
- auto:优先调用 MinerU,不可用时回落到本地解析器;
- MinerU:容器化部署(可选 GPU),对 PDF 版面、公式、表格解析效果最佳,见 Docker 部署;
- 本地解析器:轻量零依赖,支持 Markdown、TXT、DOCX、PDF 等常见格式。
:::tip 改动何时生效 修改流水线配置后,新上传的文档按新配置入库;已有文档如需按新配置重建,在文档列表选择「重新解析」即可。 :::