可观测与可回溯
RAG 系统最难的不是跑通,而是回答错的时候知道为什么错。ollmo 把每一次 Agent 图执行都完整记录下来:走了哪些节点、命中了多少检索结果、条件分支为何转向、每步耗时多少——全部可回放。
执行历史
知识库 →「历史」标签,展示每一次 Agent 图执行的记录,支持按「正式对话 / 测试运行」来源过滤:
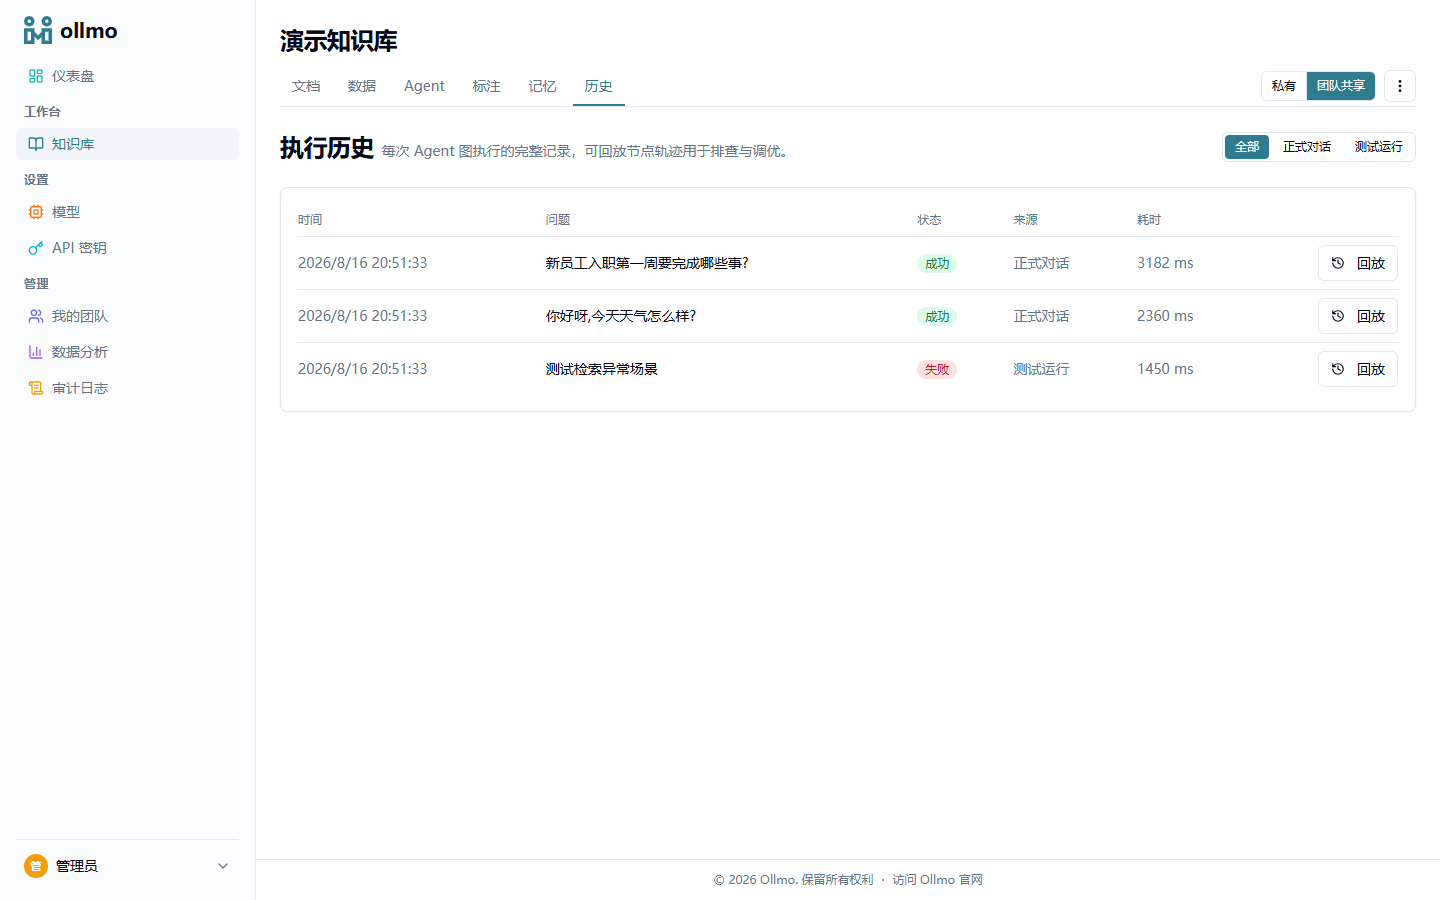
每条记录包含问题、状态、来源与总耗时。
执行回放
点击「回放」打开执行回放:问题与回答、只读画布(走过的路径高亮、节点带运行状态与耗时徽标)、以及按序展开的步骤时间线:
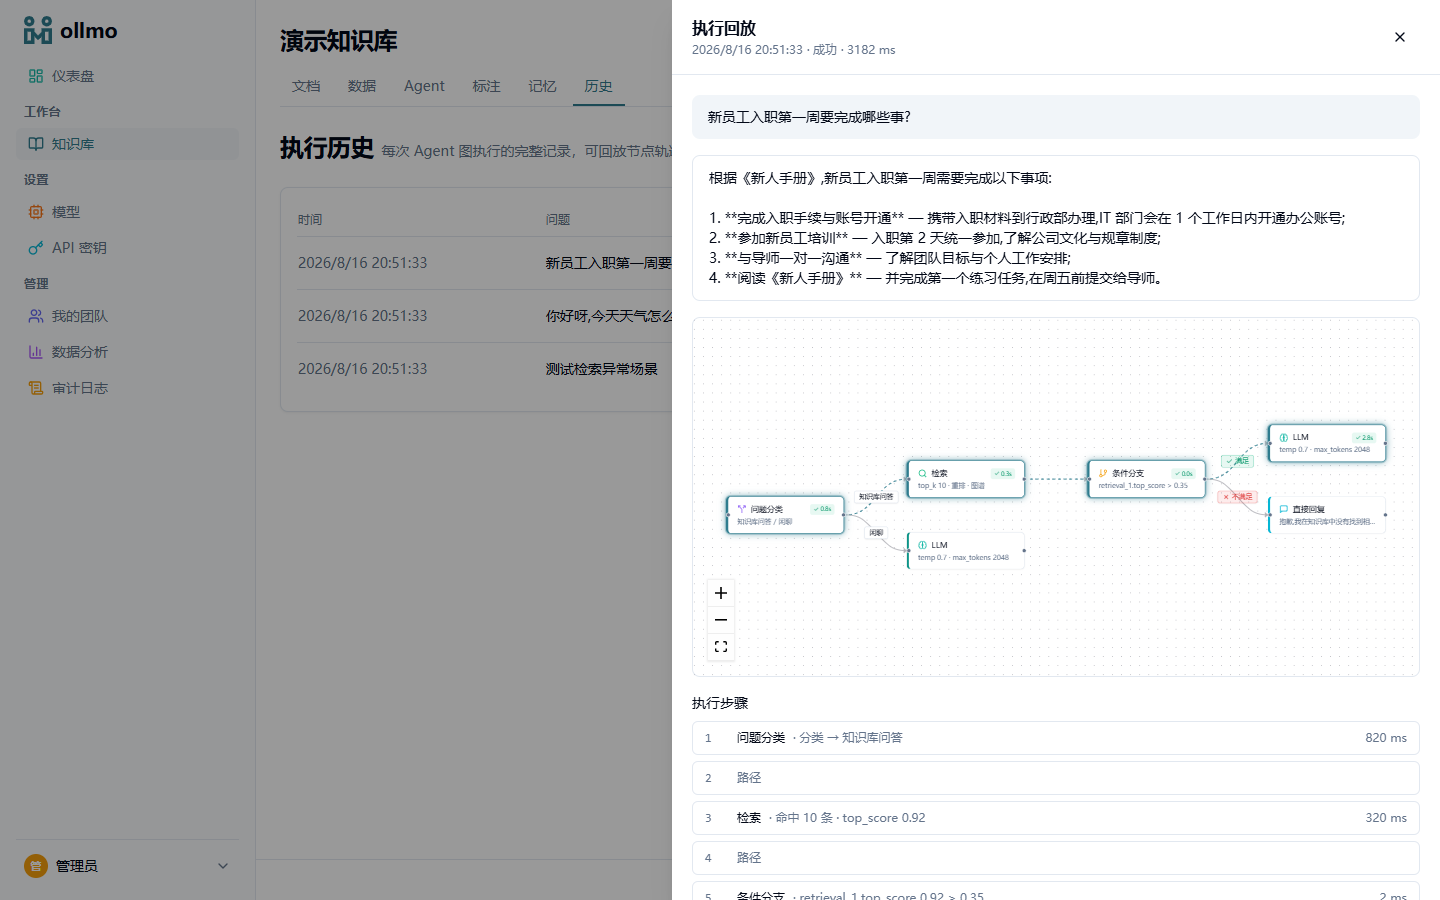
时间线逐条记录每个节点的行为细节,例如:
- 意图分类的判定结果(「分类 → 知识库问答」);
- 检索命中数与最高分(
命中 10 条 · top_score 0.92); - 条件分支的判定依据(
retrieval_1.top_score 0.92 > 0.35); - 失败节点的错误原因(如「Milvus 连接超时」)。
Bad Case 一键溯源
对话里点「踩」的回答会进入数据分析的反馈列表;从反馈列表可以直接跳转到产生该回答的执行回放,看清是分类错了、检索漏了、还是模型答偏了——不需要翻日志、不需要复现现场。
为什么这很重要
- 调优有依据:调整提示词、Rerank 或分块策略后,对比执行轨迹即可量化效果;
- 排查有现场:用户投诉"答错了"时,直接打开那次执行的回放,秒级定位环节;
- 审计有记录:每步耗时与决策过程可追溯,满足企业级治理要求。
:::tip 结合检索测试 执行回放回答"为什么这样走",检索测试回答"命中了什么"。两者配合,就是完整的检索调优工作台。 :::